
今年CNCC,“Token经济”成了算力领域最密集的关键词之一。
光合组织围绕有效Token产出,将成员海光信息的CPU+DCU双芯、中科曙光的超节点、存储、高速网络和液冷能力,以及生态伙伴的软件与应用适配,放进同一套AI基础设施框架中进行现场展示。
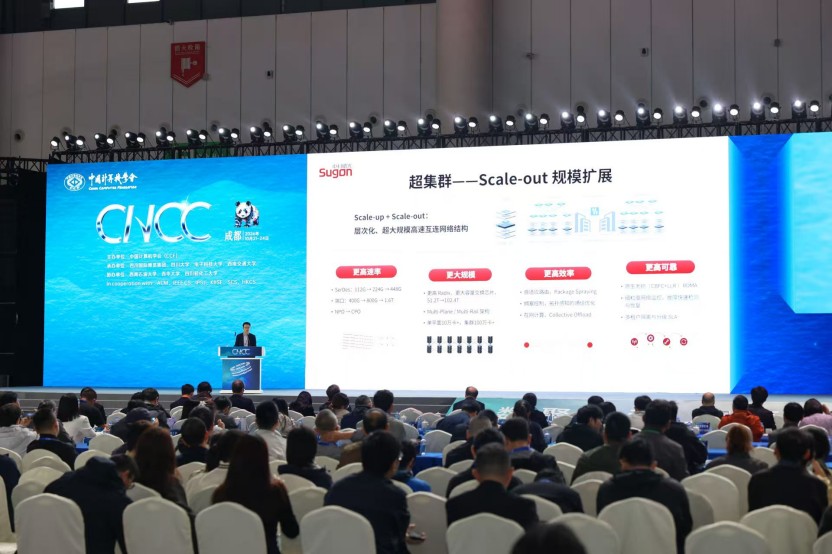
主论坛讨论Token经济下的基础设施演进,分论坛继续拆解PD分离、KV Cache和高通量调度,展区则摆出了相应的芯片、系统与解决方案。国产算力的关注重点,正从单项参数向系统实际产出延伸。
国家数据局数据显示,我国日均Token调用量已从2024年初的1000亿增长至2026年3月的140万亿,两年增长超过千倍。Agent加速落地后,大模型又从单轮问答走向任务规划、资料检索、工具调用和连续执行,一项任务所消耗的Token明显增加。
需求增长后,企业对算力的账也算得更细。采购了多少卡、峰值算力达到多少,只能说明配置规模;首Token多久出现、高并发时服务能否达标、每百万Token成本多少,才关系到应用能否规模化运行。
一枚Token生成之前,要经过计算、通信、数据读写和任务调度等多个环节。
在源头,海光DCU负责大模型训练和推理中的高密度并行计算,CPU承担数据准备、任务编排、内存管理与系统调度。海光在大会上提出从“算、传、存、调”四个环节分析Token吞吐,也点出了当前智算系统的典型问题:算子效率不高、通信时间过长、缓存反复搬运、请求排队不合理,都会造成计算资源空转。
当模型扩展到更多计算单元,中科曙光的系统能力开始接上。scaleX40超节点通过一层全交换Scale-up互联,将40张加速卡组织成紧耦合计算单元;scaleFabric高速网络再将多个超节点连接起来,支撑集群向更大规模扩展。
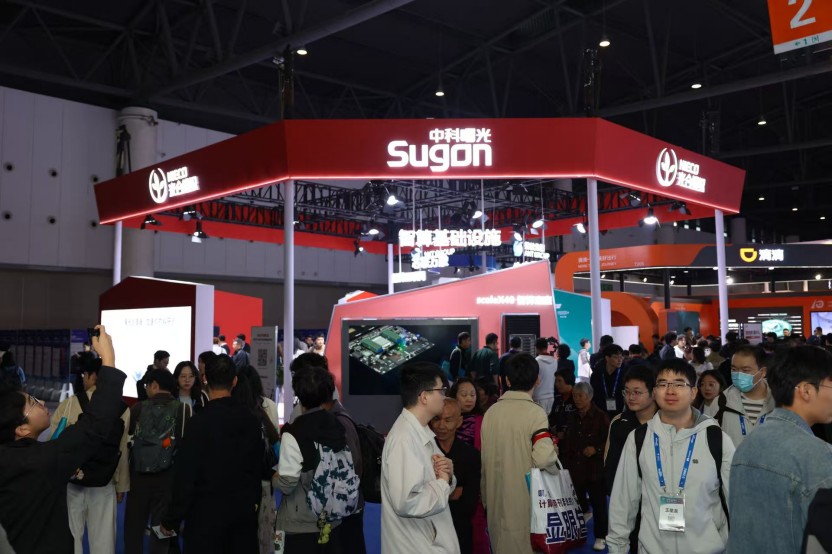
规模上去以后,数据供给很快成为新的压力点。长上下文和多轮Agent会产生大量KV Cache,显存无法完全容纳时,需要向主机内存、SSD及共享存储分层迁移。
中科曙光推出的ParaCache,利用ParaStor和FlashNexus构建外置KV Cache池。其公布的特定测试结果显示,TTFT可降低95%以上,Token吞吐提升15至25倍,64K上下文并发数提升16倍。
与此同时,中科曙光首次发布FabricView,该平台可集中纳管百万量级设备、端口与光模块,将自动配置、性能筛查、业务拓扑感知和故障恢复放进同一平台。大规模集群中的局部故障难以完全避免,发现和恢复得越快,有效运行时间就越长。
从海光双芯计算到中科曙光的超节点、存储和高速网络,AI基础设施的硬件链路已经基本成形。操作系统、模型框架、数据库和行业应用,还需要更多生态伙伴持续适配。光合组织将这些环节连接起来,让不同成员围绕同一类模型与负载完成联合验证,减少芯片、系统和应用之间的断点。
Token经济让AI基础设施开始按结果算账。芯片决定性能上限,系统协同决定最终能够兑现多少。光合组织在CNCC集中呈现的,正是国产算力从单项突破走向体系竞争的新阶段。